在噪音中理解意图:机器人离“懂你”还有多远?
在商场里,你对服务机器人说:“带我去洗手间。”它却回答:“好的,为您播放《洗手间》。”这个假想场景有些好笑,却揭示了机器人走出实验室的现实障碍:声音从来不会按指令、噪声和说话者的身份排好队,等着机器逐一处理。
对具身智能而言,语音交互不只是把一句话转成文字,还要在移动中辨认声音、结合场景理解意图,并决定何时采取行动。真正的考验,可以概括为三件事:听得见、听得懂、知道该听谁。
第一关:
听得见,先要对付自己的噪声
商场的广播、交谈和脚步声一起进入麦克风,玻璃墙面与地面又让声音反复反射。人离机器人越远,语音往往越弱,周围噪声却未必同步降低。决定它能否听清的,不只是声压大小,还有目标语音相对于干扰声的强弱,即“信噪比”。
机器人比固定音箱多了一层麻烦:关节转动、电机驱动、散热风扇都会产生“自身噪声”。这些声源离麦克风很近,而且随姿态、速度不断变化;机器人一边回答一边倾听时,自己的扬声器还会形成声学回声。单纯把麦克风调得更灵敏,只会把干扰一同放大。
可行的办法是让声学处理与身体状态协同工作。麦克风阵列根据不同位置收到的时间差估计声源方向,用波束形成突出目标区域;回声抵消削弱扬声器的影响;运动传感器和电机控制信号则帮助判断哪些噪声可能来自机器人自身。但降噪不是越猛越好,处理过度也可能削掉指令中的关键音节。如何在抑制噪声与保留语音之间取得平衡,仍是工程难点。
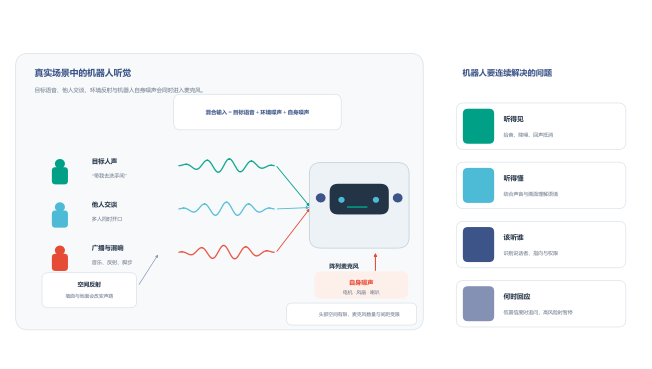
图1 真实场景中机器人听觉面临的混合声场、
自身噪声与关键判断任务。
图片来源:陈孝良 绘
第二关:
听得懂,不能只依赖转写文字
“把杯子拿过来”若被识别成“把被子拿过来”,语言模型再流利,也可能从错误的起点作出判断。语音中的停顿、重音、迟疑和环境提示,也未必能被一行文字完整保留。对于要伸手拿物体的机器人,“字听对了”不等于“事做对了”。
于是,声音开始与视觉、动作共同进入感知系统。摄像头看见桌上有水杯,用户又用手指向桌面,“拿那个”的含义便更清楚;嘴唇运动与语音节奏相吻合,还能为混合人声中的目标说话者提供线索。音视频联合分离与识别已经在部分噪声场景中表现出优势,但遮挡、逆光和镜头视野之外的说话者,仍会使这些线索失效。
更进一步,机器人还要把指令放进任务情境:手里正端着热水时,“先放下”与空手时的“先放下”,风险完全不同。多模态融合的意义,不是给语音识别再加一只眼睛,而是让声音、物体、动作和周围变化相互校验。
第三关:
该听谁,决定机器人是否真懂交流
几个人同时说话时,最大的声音不一定是对机器人发出的命令。孩子叫家长、顾客向同伴问路、工作人员提醒让道,在麦克风里可能同时出现。机器人需要结合说话方向、视线、手势、对话历史及当前任务,判断谁在向自己表达意图。
这更接近人类常说的“鸡尾酒会问题”:从纷杂声场中选出值得关注的声音。不过,机器人还必须识别说话者的角色与指令权限。例如路人喊“停下”,可能是紧急避险提示;有人让它搬走别人的物品,却不能仅凭一句话照做。所谓“理解意图”,只是对可见、可听证据的推断,不能等同于读心术。
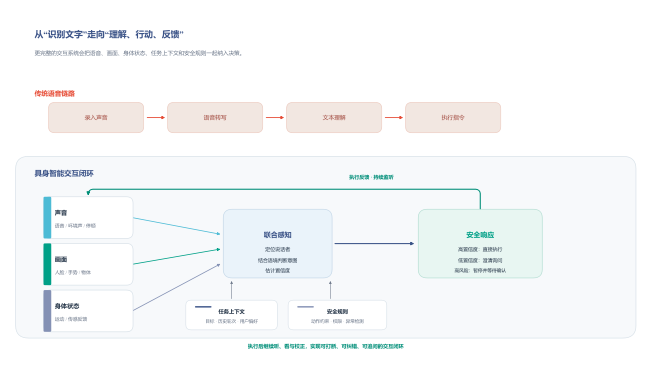
图2 多模态感知、上下文约束与
安全响应构成的交互闭环。
图片来源:陈孝良 绘
真正的最后一公里:边听边做,允许打断
现实对话不是你说完一句、机器再播放一句。人会改口、插话、半途叫停。全双工语音技术尝试让机器在发声的同时持续接收外界语音;具身机器人还要进一步把这一能力接入运动控制和安全机制。听到“等等”,它首先应评估是否立即减速或暂停,而不是等整段语音识别完毕再行动。
因此,不能只用安静环境里的识别准确率评价机器人。更应看它在人群、混响与自身运动中能否稳定辨认目标,遇到含糊指令能否追问,发生误解能否及时撤回动作,以及是否始终遵守安全边界。实验室里的成功演示,距离长期、可靠的公共场所服务仍有距离。
具身智能跨越嘈杂环境的关键,不是让机器人听得更远,而是让它把声学感知、视觉理解、行动反馈和风险判断连成闭环:该听时听,该看时看,有歧义先确认,有危险先停下。最可靠的回答,有时并不是“好的”,而是“您能再说一遍吗?”
作者:陈孝良 中国声学学会理事,声智科技研究员
审核:刘颖 李培元 张超 杨柳